
模数共振:智物联把工厂数据变成AI能用的 “场景数据”
今年,工信部、国家数据局推动模数共振行动,提出构建 “数据‑模型‑场景” 飞轮,这一概念成为了工业AI落地的核心指引。
但对于大量企业,现实困境却是:传感器配齐、数据平台建成,可想要训练自己的工业AI模型时,数据却无法使用,模数共振飞轮难以转动。飞轮转不动,问题往往不在于大模型能力不足,而是卡在数据供给这一源头。有数据,不等于拥有能供给AI的场景化数据。
工厂现场设备品牌繁杂、新旧跨度大,多协议并存,数据命名、格式互不统一。传统系统只完成数据采集存储,缺少工业语义关联,振动、温度、电流等参数相互割裂,再叠加现场噪声、网络抖动带来的数据缺失和异常,原始数据杂乱无序。即便接入通用大模型,AI也无法读懂设备真实工况,自然无法输出可靠分析结果。
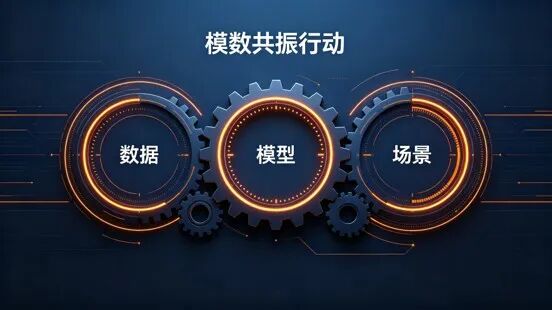
想要激活模数共振飞轮,需要完成工业数据的场景化治理,这正是智物联MixIOT智慧工业互联网核心引擎重点解决的问题。
智物联以多源异构映射为核心方法论,让工厂告别简单的数据搬运。无论底层设备是全新智能装备还是一些服役多年的老旧机组,经过统一建模,各类私有协议数据被清洗为标准化工业语义的数据。这些数据相当于工业AI的标准化原料,参数含义明确、时序对齐、质量标记完整,可以直接供给上层算法与模型训练使用。
现实生产中,大量工厂存量老设备接口封闭、硬件改造风险高,成为数据接入最大阻碍。智物联APRUS网关适配器采用非侵入式采集方案,不改动原有控制系统,兼容上百种工业协议,实现老旧设备快速接入。
面对内网隔离、网络不稳定的厂区环境,搭配智联宝盒边缘计算服务器,可以在生产现场就地完成数据清洗、归一建模,不需要全部数据外传到云端,既保障生产网络安全,又能输出可用于AI计算的高质量数据集。
从APRUS现场采集,到智联宝盒边缘侧预处理,再经由MixIOT完成物联对象建模输出栅格数据,形成一套完整链路:现场原始设备数据→标准化场景数据集→AI模型训练→业务场景验证,打通模数共振的数据基础环节。企业无需推倒重建现有产线,以试点方式从单类设备、单个站房起步,验证效果后再逐步扩大范围,保护原有数字化投资。
对于制造企业,在模数共振政策推进下不妨先做一次数据自检:关键设备数据是否全覆盖、多源数据是否完成语义统一、数据质量是否满足算法训练要求。
模数共振,模型与场景再先进,也要先筑牢数据底座。 依托智物联MixIOT数智底座成熟的数据处理能力,把原始设备数据转化为AI可用的场景数据,方可迈出工业AI规模化落地的第一步。